【初学者向け】現場で使える Ruby on Rails5 速習実践ガイドを読んだ感想
はじめに
現場で使える Ruby on Rails5 速習実践ガイドを読んだ感想をまとめを書いていきます。
よかったところ
rubyの基礎、ユーザー管理アプリケーション、todo管理アプリケーションを通じて一連の流れを体系的に学ぶことができる
特に3章から7章までのtodoアプリケーションと追加機能の部分では、railsの機能面やどういう処理をしているのかを図やコードで解説がされているので、初学者でも食らいついて開発することができた。
学んだこと
今回のtodoアプリで参考にした環境構築記事はこちらです。
Ruby on Rails 7 with Bootstrap on Docker Compose 開発環境を簡単に構築する方法 #Ruby - Qiita
Ruby on Rails 7.1 with Bootstrap on Docker Compose 開発環境を構築する方法 #Ruby - Qiita
環境構築で詰まりまくって肝心の書籍の内容が全く進まずにどんどん進捗が遅れてしんどいぞ...という状況に陥ったので、もし記事を拝見された方に参考になれば幸いです。(自分は訳わからなくって再度環境構築し直しました...)
以降は章ごとでピックアップして学んだことをまとめていきます。
Chapter 2
RailsのMVC(Model-View-Controller)アーキテクチャは、アプリケーションの設計を整理し、効率的に開発できるようになる。
モデル:アプリのデータとそのデータを操作するロジックを担います。主にデータベースとのやり取りを管理し、データの保存や読み込みを行います。
ビュー:ユーザーに表示される画面の部分で、HTMLで構成されます。コントローラーから受け取ったデータを元に、ユーザーが見るページを作り上げます。
コントローラー:ユーザーの入力を受け取り、それに応じてモデルを使ってデータを処理し、最終的にビューを介してユーザーに結果を表示します。つまり、モデルとビューの橋渡し役を果たします。
Chapter 3
paramsオブジェクトの活用
Railsでは、これらのメソッドから送られたデータをparamsオブジェクトを通じて受け取ります。
paramsはコントローラ内で使えるハッシュのようなオブジェクトで、フォームやURLから送られたデータにアクセスできる。
def search
  keyword = params[:keyword]
  # ここでkeywordを使った検索処理を行う
end
効率的なコントローラの設計
コントローラのアクションを定義する際、GETメソッドを使うアクション名を選ぶと、そのアクションは同名のビューファイルをレンダリングすることが多く、開発がスムーズに進む。
renderとredirect_to
レンダーとリダイレクト:データ送信後の処理には、レンダー(再描画)とリダイレクト(新しいリクエストの発行)の二つがあります。例えば、フォーム送信に失敗した時は同じフォームを再描画し、成功した時は別のページへリダイレクトします。
simple_formatメソッド:テキストに含まれる改行をHTMLの<br>タグに変換し、XSS攻撃を防ぐためのエスケープも行います。これにより、ユーザーが入力したテキストを安全に表示できます。パーシャル:インスタンス変数ではなくローカル変数を渡すことで、その再利用性と可読性を高めることができる。
Chapter 4
モデルの基本
モデルは、アプリケーションの「モデル層」を形成し、データとビジネスロジック(データに関する処理や規則)を担当します。具体的には、以下の二つの主要な要素から構成されます。
Railsでは、モデルのクラス名はキャメルケースで表記され、対応するテーブル名はその複数形のスネークケースで命名されます(例:モデルクラスUserはテーブルusersに対応します)。
モデルの作成
モデルの作成には、Railsが提供するジェネレータコマンドを使用します。このコマンドは、モデルのクラスファイルとデータベースのマイグレーションファイルを自動で生成し、テストファイルなども同時に作成します。
bin/rails g model ModelName attribute:type
例えば、nameとcontent属性を持つTaskモデルを作成する場合、以下のようにコマンドを実行します。
bin/rails g model Task name:string content:text
マイグレーション
マイグレーションは、データベースのスキーマ(テーブルやカラムの構造)をバージョン管理する仕組みです。モデル生成時に作成されるマイグレーションファイルを用いて、テーブルの作成や変更を行います。マイグレーションファイルはRubyで記述され、bin/rails db:migrateコマンドでデータベースに適用されます。
class CreateTasks < ActiveRecord::Migration[6.0]
  def change
    create_table :tasks do |t|
      t.string :name, null: false
      t.text :content
      t.timestamps
    end
  end
end
マイグレーションを適用することで、モデルで定義された属性に対応するテーブルがデータベースに作成される。
また、マイグレーションはロールバックが可能で、bin/rails db:rollbackコマンドで直前のマイグレーションを取り消すことが可能。
Chapter5
テストのメリット
- 自動テストにより、動作確認の大部分を自動化し、テストコストを大幅に削減
- 環境のバージョンアップやリファクタリング時に必須
- テストを通じてシステム全体の影響を検討し、全体像を掴みやすくする
- テストは開発チーム内で期待する動作の詳細を共有する手段
- テストを書きやすいコードを意識することで、管理しやすいコード構成を促進
- テストが仕様のドキュメントとして機能し、仕様書の役割を果たす
- テスト作成過程で仕様バグや要件の詰め漏れを発見しやすくなる
- テストの存在を意識することで、テストしやすいプロダクトコードに自然となる
Chapter 6: ルーティング
Railsのルーティングシステムは、RESTfulなウェブアプリケーションの設計に必要な要素。
resourcesメソッドを使うことで、CRUD操作に必要なルーティングを一括で生成できるため便利。
scope,namespace,controllerといったカスタムメソッドで、ルーティングを柔軟に行うことができる。
  namespace :admin do
    resources :users
  end
難しかったところ
本書が2018年発行のため、rails7環境だとかなり頻繁にエラーが発生するのでそのエラーを解決しながら進むため体力と時間と根気の勝負だった。
また、今回はDockerを用いて環境構築していたためそのエラーも頻発してかなり苦労した。
slim形式でコードが書かれているのでerbに置き換えて実行していたので、読むのに苦労した。
終わりに
Docker × rails7 × bootstrap5で環境構築していて詰まる部分もたくさんあって、一時は1から環境構築までしましたが、先人たちの知恵と記事のおかげでたくさん学びがありました。 progateやドットインストールなどで予めある程度の基礎知識がある状態で、この本を読むとかなり効果的に学べると思うので、私と同じくWeb開発系に進むために勉強をされている方にはぴったりな一冊だと思いました。
【初学者向け】REST APIについてまとめてみた
REST APIについて学習したので、まとめていきたいと思います。
APIって何?
API = ApplicationProgramInterface
- 他のサービスの情報や機能を利用可能にする仕組み
RESTとは?
REST(REpresentational State Transfer)
6つの制約条件
- クライアントサーバー: ユーザーインターフェースとデータ処理の分離。
- 階層化システム: システムの階層的構造による拡張性の向上。
- コードオンデマンド: 必要に応じてクライアントにコードを送信。
- 統一インターフェース: 標準的なHTTPメソッドによるリソース操作。
- キャッシュ制御: クライアントとサーバーの通信回数と量を減らすことでの通信効率向上。
- ステートレス: 各リクエストの独立性。
上記に基づいて実装されたAPIをREST APIと呼びます。
movieリソースを操作するためのREST API設計例
下記の表では、/moviesは映画の一覧または映画に関する情報のリソースを表し、/movies/12345の数字部分は特定の映画(リソース)のIDを示しています。HTTPメソッド(GET、POST、PUT、DELETE)は、リソースに対する操作(読み取り、作成、更新、削除)を指定するために使用されます。
| 操作 | URI | HTTPメソッド |
|---|---|---|
| 映画一覧の取得 | /movies |
GET |
| 特定の映画をIDで取得 | /movies/12345 |
GET |
| 映画の新規登録 | /movies |
POST |
| 特定の映画の更新 | /movies/12345 |
PUT |
| 特定の映画の削除 | /movies/12345 |
DELETE |
設計ポイント
【初学者向け】スッキリわかるSQL入門の感想
はじめに
スッキリわかるSQL入門 第3版を読了したので、こちらにまとめたいと思います。
良かったところ
- イラストや図形、コードがちゃんと記載されているので初学者でも抵抗なく学べる
- dokoQLという書籍用のDBが用意されているのでインプット→アウトプットがスムーズに行える。また、結果表でどのように出力されるのかを可視化できるのは手を動かしながら行えるのでとても良い。
- 論理設計メインだが、物理設計の内容も紹介されているので良い
- 付録でそれぞれのDBの簡易リファレンスがついている
- 256問の特訓ドリルが用意されているので、インプットだけで終わりではなくアウトプットもしっかり行える
dokoQLについて
ログインせずにもできますが、機能制限で書籍を読み進める妨げになるのでアカウント作成がオススメです。
左端のメニューバーの一番上にライブラリをクリックしてもらうと、そこから書籍の版数を選択できるます。選択していただくと、各章のコードと章末問題の解答、付録の特訓ドリルにある3つのデータベースが開けるようになっています。
進め方について
僕自身1章から12章までを綺麗に全部読んで、その後256問解き読了したのですが非常に効率の悪いやり方だったなと反省しました。
この本を読んだことがなく、SQLをまだ学び始めて日が浅い方向けにおすすめの読み方を紹介します。
この本の構成として、1章から12章まであって後ろに256問の特訓ドリルで構成されています。
さらに特訓ドリルの内訳として、3つのデータベースがあり1つのデータベースで70問用意されています。210(70問×3)問分は2章〜8章の内容です。
なので、1章&2章(章末問題も含めて)を終わらせて、特訓ドリルの3つのデータベースの2章の部分の問題を解く。 3章から8章も上記の流れで解いてもらうのが、効率よくインプット→アウトプットの流れができると思います。
補足: 特訓ドリルの問題は、先述したdokoQLのライブラリから版数を選択して、付録の特訓ドリル項目から3つのデータベースを選択してもらうとDB,エディタ,結果が分かる画面に映るので実際に手を動かしながらやった方が絶対良いです。
9章から12章を一気に読み進めて、最後特訓ドリルの残りの問題を解いてフィニッシュです!
少しでも書籍を読み進める手助けになれば嬉しいです。
学んだこと
ここからは学んだことのまとめを書いていきます。
SQLとは?
- データベースマネジメントシステムに対して、SQL文(命令文)を送信してデータベースの読み書きを実行する
4大命令とは
- SELECT,UPDATE,DELETE,INSERTの4つ
- 4大命令の分類
- 検索系:SELECT
- 更新系:UPDATE,DELETE,INSERT
- 処理対象とするテーブル名を必ず指定する
- UPDATE文とDELETE文はWHERE句で対象の行を絞り込まないとテーブル全件に変更が適用されてしまう
WHERE句
- 対象データの絞り込みに利用
- SELECT, UPDATE, DELETE文で使うことができる演算子
演算子
比較演算子
<=: 左辺は右辺の値以下>=: 左辺は右辺の値以上<>: 左右の値が等しくないIS NULL,LIKE,BETWEEN,IN,ANY,ALL
論理演算子
AND,OR,NOT- 論理演算子は、
NOT、AND、ORの順で優先度が高く、先に評価される
NULL
- データが格納されておらず、未定義の状態を「NULLが格納されている」と表現する
- 数字のゼロや空白文字とは異なる
NULLは=で判定できないIS NULLもしくはIS NOT NULLで判定
主キー
- 「この値を指定することで、ある1行を完全に特定できる」という役割を担う列のこと
- プライマリーキー(primary key)ともいう
自然キー (Natural Key)
- 自然に登場し、主キーの役割を果たせる列のこと
- 例: 社員情報を管理する社員テーブルで、名前や性別に加えて社員番号という列が自然に思いつく
人工キー (Artificial Key) または代替キー (Surrogate Key)
- 管理目的のためだけに人為的に追加された列のこと
検索結果の加工
主なキーワード
- DISTINCT
- 重複行を除外する
- ORDER BY
- 順序を並べ替える
- DBMSにとっては負荷のかかる作業
- LIMIT / OFFSET - FETCH
- 件数を限定して取得する
- UNION / EXCEPT / INTERSECT
- 検索結果の集合演算(和集合、差集合、積集合)
関数
- 関数は文字列関数、算術関数、日付関数、変換関数などに分類される。
- 実際のSQL文記述を通じて覚える。
集計関数
- SUM
- 各行の値の合計を求める
- MAX
- 各行の値の最大値を求める
- MIN
- 各行の値の最小値を求める
- AVG
- 各行の値の平均値を求める
- COUNT
- 行数をカウントする
COUNT(*)はNULLの行も含めてカウントCOUNT(列)はNULLでない行のみカウント
集計関数の注意点
- SELECT文、ORDER BY句、HAVING句でのみ使用可能。
- WHERE句では使用不可。
- 結果表は必ず長方形になる。
グループ化
- GROUP BY
- 集計に先立って、指定した基準で検索結果をグループ分けする。
- HAVING
- 集計処理を行った後の結果表に対する絞り込みに使用。
その他の関数
- COALESCE
- 最初に登場するNULLでない値を返す。
副問い合わせ(サブクエリ)
副問い合わせのパターン
- 単一行副問い合わせ: 結果が1行1列になるもの。
- 複数行副問い合わせ: 結果が複数行1列になるもの。
- 表形式副問い合わせ: 結果がn行m列の表になるもの。
複数テーブルの結合
データベースでは、データを複数のテーブルに分けて格納し、外部キーを使用してリレーションシップを構築します。これにより、結合を用いて複数のテーブルに格納された関連データを1つの結果表にまとめることができます。
結合の種類
- INNER JOIN: 条件に一致するレコードのみを表示。
- LEFT JOIN / RIGHT JOIN: 片方のテーブルにないデータはNULLとして表示。
- OUTER JOIN: どちらかのテーブルにあるレコードを全て表示。
トランザクション
トランザクションは、複数のSQL文を1つの命令として扱うもので、DBMSはトランザクションの原子性や分離性を保つように制御します。
トランザクションの特性
- 原子性: 全ての処理が実行されるか、1つも実行されない。
- 分離性: 他のトランザクションからの影響を受けない。
- ロック: 行や表、データベース全体にロックをかけることができる。
テーブルの作成
データベースにデータの出し入れを指示する立場と、必要なテーブル準備や設定を行う立場があります。
SQL命令の種類
- DML (Data Manipulation Language): データの格納、取り出し、更新、削除。
- DDL (Data Definition Language): テーブルの作成、削除、設定変更。
テーブル作成時の制約
- NOT NULL制約: NULLの格納を防ぐ。
- UNIQUE制約: 重複した値の格納を防ぐ。
- CHECK制約: 値の妥当性をチェック。
- 主キー制約: 主キーとして扱う列に設定。
様々な支援機能
インデックス
- テーブルの列に索引情報を生成。
- インデックスが存在する列の検索は高速化されるが、書き込み性能の低下もあるため乱用は禁物。
ビュー
- SELECT文の結果表を仮想的なテーブルとして扱う。
バックアップ
- ACID特性(原子性、一貫性、分離性、永続性)を保証するために重要。
- ログファイルもバックアップし、障害時にロールフォワードで復元可能。
テーブルの設計
データベース設計のプロセス
おわりに
ページ数が多いので技術書慣れしていない分大変苦労して読み切りました。
そのおかげか、書籍の全体の構成を把握してどのように進めばいいのかということも工夫して効率良く学ぼうときっかけをくれた教材でした。
SQL自体がかなり久しぶりだったので、改めて体系的に学ぶことができて良かったです。
【微初学者向け】達人に学ぶDB設計 徹底指南書の感想
はじめに
達人に学ぶDB設計を読了しましたので、感想と学習した内容をまとめて書いていきたいと思います。
Amazon.co.jp: 達人に学ぶdb設計 徹底指南書 初級者で終わりたく無いあなたへ
良かったところ
- 論理設計と物理設計についてメジャーな手法を丁寧に解説している
- DB設計は基本的にトレードオフ(二律背反)の関係であることを前提に、望ましい設計方法を記載している
- コード例と図の解説があるため、イメージがしやすい
学んだこと
第1章
- データベースはデータ集積の論理的概念、DBMSはデータベースを実装したソフトウェア
- データベース設計を制するものはシステム開発を制する
データ中心アプローチ(DataOrientedApproach:DOA)が主流。プログラムよりも前にデータの設計から始める方法論
3層スキーマ:データベース設計においては、データベースのデータ構造やフォーマットという意味
- 概念スキーマの必要性
第2章
論理設計
論理設計は物理設計に先立つ
論理設計フロー
- エンティティ抽出
- エンティティ(実体)といっても、物理的実体に伴う必要はない,データをどう扱うかの問い
- エンティティ定義
- データを属性(列)という形で保持する,重要なのはkeyを定義すること
正規化
- 正規化が最も重要な土台となる,システムでの利用がスムーズに行えるための作業
- 特に正規化は更新(データの更新、変更、削除)が整合的に行えるようにフォーマットを整理する
ER図
- 各エンティティの関係をわかりやすくするために作成する
- エンティティ抽出
物理設計
- テーブル定義
- インデックス定義
- インデックス(索引)は重要な概念であり、パフォーマンスに影響を与える
- ハードウェアのサイジング
- サイジングには2通りの意味がある
- システムで利用するデータサイズの見積もり、十分な記憶装置(ストレージ)を選定,システムが十分な性能を発揮できるかサーバのCPUやメモリを選定する
- 性能問題のほとんどが、ストレージのI/Oネック(ディスクI/O)
- ストレージの冗長構成の決定
- ストレージの冗長構成は、データの安全性と可用性を保証しつつ、コストとパフォーマンスのバランスを取る
- RAID(Redundant Arrays of lnexpensive Disks)の略で、 複数のハードディスクをひとつのドライブのように認識させる技術
- ファイルの物理配置の決定
- DBA(DatabaseAdministrator):システムファイル,一時ファイル,ログファイル
- データファイル
- ユーザーがデータベースに格納するデータを保持するためのファイル
- 業務アプリケーションがSQLを通じて参照、更新を行うファイル
- インデックスファイル
- システムファイル
- DBMSの内部管理用に使われるデータを格納
- 一時ファイル
- ログファイル
- DBMSはテーブルのデータ変更を受け付けた場合、即座に変更しているわけではなくログファイルに変更分を溜めて一括でデータファイルに変更を反映している
- PostgreSQLでは、トランザクションログ
- データファイルに変更が終われば不要のため削除される
バックアップ設計
- データ損失を防ぐためには、極力データを失わない設計にするorデータが失われた時に復旧できるようにする
バックアップの基本はファイルコピー
バックアップの種類は大きく3通り
- 3つの方式を組み合わせていく、どれか一つだけというのは普通ない
リカバリ設計
- バックアップ設計とリカバリ設計はセットで実施される
- バックアップ方式が決まれば、リカバリ設計も決まる
- リストア:バックアップファイルを戻す作業
- フルバックアップのファイルをデータベースに戻す
- リカバリ:そのファイルに対してトランザクションログを適用して変更分を反映する作業
- 差分(または増分)バックアップしていたトランザクションログを適用する
- ロールフォワード:DBMSの内部にもトランザクションログが残っている
- 未バックアップのトランザクションログを適用すること
第3章
テーブルとは?
- RDBMSでは、あらゆるデータをテーブルという単位で扱う.
- テーブルとは、共通点を持ったレコードの集合である。
- テーブルは複数形または複数名詞で書ける.かけない場合はそのテーブルには間違いがある
- 列(カラム) 行(レコード)
- 主キー=一部に識別する 一意=unique
- 複合キー:複数列を組み合わせてできるキー
正規化
正規化の主な目的は、データの冗長性を減らし、データの整合性を高めること
- 正規化とは、現実世界の実体間にある階層の差を反映する手段でもある
- 無損失分解:情報を完全に保存したままテーブルを分割できる
- 正規化は必ず元に戻せなくてはならない
- 正規化の逆操作は結合
- 基本的に第3正規形で十分
正規化のメリット
- データの冗長性の削減
- データの整合性の向上
正規化のデメリット
- クエリの複雑化
- パフォーマンスの低下
- 過度な正規化によるテーブル結合の増加は、パフォーマンスを低下させる可能性がある
- 設計の複雑化
- 正規化のプロセスが複雑で、設計に時間がかかる場合がある
第1正規形:一つのセルの中には一つの値しか含まれない
- scalar value = scalarは単一のという意味
- 1つのセルに値を複数入れ込む場合は、列を増やすか行を増やすかの2択
- 基本的には行を増やすパターン
- 第2正規形:部分関数従属を解消することで得られる
- 関数従属性(functional dependency):Y=f(X) YはXに従属する
- セルに複数の値を許せば、主キーが各列の値を一意に決定することが出来ないから
- 解消方法はテーブルの分割
- 部分関数従属の関係にある列と従属列だけ独立のテーブルにする
- 第3正規形 推移的関数従属
- テーブル内部に存在する段階的な従属関数のことを推移的関数従属
- ex)従業員ID → 部署ID → 部署名 のように、従業員ID が 部署名 に間接的に依存している状態
- 正規化は常にするべきか?
- 第3正規形までは原則として行う
- 関連エンティティが存在する場合は、関連とエンティティが1対1に対応するように注意する
第4章
ER図
- なぜER図を作成しなければならないのか?
- テーブル(エンティティ)の数が増えると、テーブル同士の関係がわからなくなり設計に支障をきたすため
- ER図:テーブル同士の関連を記述する道具
- RDBのテーブル間の関係は基本的には1対多
- 1対1
- 1対1のレコードはあまり見かけない
- 二つのテーブルの主キーが一致するケース→普通は一つにまとめてしまう
- 1対多
- 0または1以上と1以上がある
- 多対多
- 業務要件テーブルからテーブルを作っていくとこのパターンになることが多い
多対多の解消法
- 間に人工的に作り出したエンティティを挟む
- 多対多の関係は一対多の関連に分解すること
- 多対多の関連を一対多に分解するときに必要となるエンティティを関連実体と呼ぶ
ER図の作成
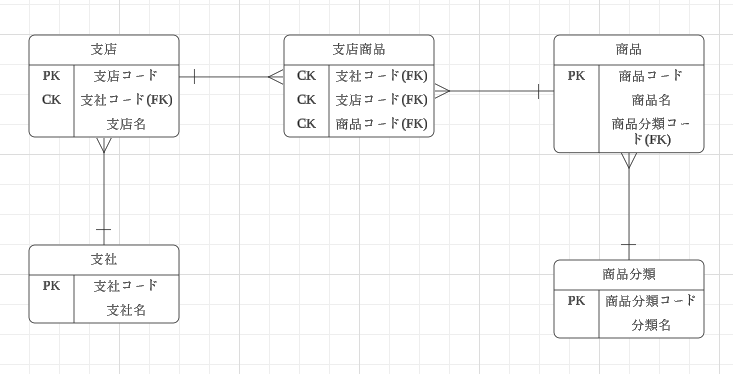
ER図の作成にはLucid Chartを使いました。無料で直感的に作れるのでおすすめです。
下の図は実際にLucid Chartを用いて作成したER図です。
第5章
正規化の功罪
- 正規化の原則とトレードオフ
- 正規化はデータベース設計において、可能な限り高次の正規形を目指すことが原則
- なぜなら、データの冗長性を減らし、整合性を高めることができるから
- 非正規化はあくまで最終手段
- 正規化の冗長性排除によって起こる2つの問題
- サマリーデータの冗長性排除
- 問題点: データベースでのメンテナンス作業がとても複雑になる,集計処理のパフォーマンス低下
- 選択条件の冗長性排除
- 問題点: クエリの複雑化と特定のクエリへの非効率性,選択条件を冗長化すると正規形が1つ下がる
- サマリーデータの冗長性排除
第6章
データベースとパフォーマンス
- データベースのパフォーマンスを決める主な要因
- インデックスはパフォーマンス向上に有効な道具だが、正しく使わないと効果が発揮されない
- 統計情報はDBMSにとっては地図情報 最新でなければ最短のアクセスパスを選ぶことができない
インデックス
- インデックス = (x, α)
- xはキー値, αはそれに結びつく情報,実データorポインタ ポインタであることが多い
インデックス設計
- インデックスはSQLパフォーマンス改善のために非常にポピュラーな手法
- アプリケーションのコードに影響を与えない。(アプリケーション透過的)
- テーブルのデータに影響を与えない(データ透過的)
- 性能改善が大きい
- 存在を意識しなくても良い = 透過性(transparency)
- インデックスは闇雲に作っても効果は出ないので、正しく指針を理解した上で使う
B-treeインデックスと5つの特性
- B-treeインデックスとは?
- 最下層のリーフ(葉)と呼ばれるノードだけが、実データに対するポインタを保持している
- 最上位のノード(ルート)から順にノードを辿ってリーフから実データを見つけにいく
5つの特性
- 均一性
- B-tree = 平衡木である.どんなキー値を使っても、常にリーフまでの距離が一定になるため探索を同じ計算量で行える
- 平衡木:どのリーフもルートからの距離(高さ)が一定の木のことを指す
- 持続性
- B-treeの性能劣化は長期的に見ても緩やか
- 処理汎用性
- B-treeインデックスは、挿入、更新、削除コストも検索と同じくデータ量nに対してO(log n)
- 非等値性
- B-treeは等号のみならず不等号やbetweenといった検索範囲の条件に対しても高速化を可能とする 構築される時に必ずキー値をソートするため、リーフノードを一つに絞れなくても左右のノードだけに探索範囲を絞ることが可能になる.
- B-treeが効果を持たない検索条件:否定条件(<>,!=)
- 親ソート性
統計情報
SQL文によってテーブルにアクセスする流れ
1.SQL文がDBMSへ発行される。最初はparse(解析)と呼ばれるモジュールが適切な構文であるかをチェックする
2.optimizer(最適化)モジュールが実行計画(SQLのアクセスパス)を決める
3.optimizerが実行計画を立てるときに統計情報が必要なので、カタログマネージャというモジュールに統計情報の照会をかける
4.カタログマネージャから統計情報を受け取り、オプティマイザは最短経路を選択しSQL手続きに変換する
5.その時得られた結果が実行計画であり、実行計画をもとに実データへアクセスを行う
第7章
バッドノウハウ
- RDBにおける論理設計の基本は正規化
- バッドノウハウ:原則に反した設計
代表的なバッドノウハウ
非スカラ値(第1正規形未満)
- 非スカラ値:1つのセルに複数の値がある状態
- 配列型の機能によりテーブルを一つの列を配列として扱うことができるため
- 意味的に分割できる限り、なるべく分割して保持する。
- 意味が分からなくなるぐらい分割するのはNG
- 分割したものを後で結合するのは簡単、逆は難しい。
ダブルミーニング
- 同一列のデータなのに途中から格納する値を変えること
- 列は変数ではない、一度意味を決めたら変更不可
単一参照テーブル
- 複数の趣旨が違うテーブルを一つにまとめること
- テーブル数は減る -SELECT文を共通化できる
- 可変長文字列で宣言する必要がある -レコード数が多くなり検索のパフォーマンスが悪化する -コード名を間違えてもエラーが出ないためバグに気づきにくい -ER図の精度と可読性がかなり下がる
テーブル分割
水平分割
- レコード単位にテーブルを分割すること
- パフォーマンス向上のためだけの物理レベルでの分割は、データ管理上の意味を持たない。
- 分割することで拡張性が低くなる
- DBMSのパーティション機能を利用することで、テーブルを分割せずにデータの物理的な格納領域を分離可能。
- パーティションにより、SQLがアクセスするデータ量を効率的に減らせる。
垂直分割
- 列単位にテーブルを分割する
- ボトルネックがストレージのI/Oコストのみに限り、主に検索する列だけで分割すればパフォーマンス改善はできる
- 基本的にはあまり垂直分割する意味がない
- DBMSの集約機能の集約機能で代替え可能
集約
列の絞り込み
- 頻繁に参照される列だけを持った新しいテーブルを追加作成(データマート)
- マートの利点:オリジナルのテーブルを意味破壊することなくパフォーマンスも向上できる
マートの注意点:
- マートの作りすぎでストレージ圧迫
- データの同期をすること→オリジナルの値が更新された場合は、マートの同じ値も更新しなければならない マートの更新タイミングが短いとデータの精度が高いが、更新処理の負荷がかかるため性能問題が帰って悪化する可能性もある
マートの更新頻度:バッチ更新(一括処理)で1日に1回から数回
サマリテーブル
- サマリテーブル:集約の手段の一つ。
- 列の絞り込みと違う点は、集約関数によってレコードを集約した状態で保持する
- 定期的に元のテーブルから値を取得し直す必要がある
不適切なキー
- 使ってはダメなデータ型はVARCHAR(可変長文字列)
- キーが満たすべき条件である不変性(Stability)を備えていない
- 固定長文字列(CHAR)との混同する
- コロコロ変わる列をキーにすると、データ更新処理が多く発生するためシステムの安定的な運用とパフォーマンスの両面でマイナスになる
- キーには固定長文字列のコード列が望ましい
ダブルマスタ
- ダブルマスタ:同じ役割を果たすはずのマスタテーブルが2つあること
- unionによってAテーブル、Bテーブルを結合できるが高コストのため推奨しない
- ダブルマスタはシステムの統廃合で起きやすい
第8章
論理設計のグレーノウハウ
代理キー
- 使用状況: 主キーが不適切または存在しない場合に使用。
- パターン:
- 一意キーがない: データ重複を排除するためのデータクレンジングが必要。
- キーがサイクリックに使い回される: 履歴情報の管理が必要。
- キーが途中で変化する: 合併などでキーが変わる場合、履歴管理が必要。
代理キーの解決策
- システム側で一意なキーを付与して、自然キーに関連する問題を解決。
自然キーによる解決
- パターン1: アプリケーションでデータを一意に整形。
- パターン2と3: 履歴管理のための時間列(タイムスタンプまたはインターバル)を追加。
オートナンバリング
- シーケンスオブジェクトやID列を使用して一意な連番を自動的に割り振る。
- アプリケーション側での採番テーブルを使用する方法もあるが、依存関係や排他制御の問題がある。
列持ちテーブル
- メリット: シンプルな設計、入出力フォーマットとの整合性が高い。
- デメリット: 列の増減が激しい、無用のnullの使用、行持ちテーブルへの変換が必要。
アドホックな集計キー
- 問題: 地方別人口合計など、集計キーが存在しない場合の集計が困難。
- 解決策: キーを別テーブルに分離、ビューの使用、group by句でアドホックキーを作成。
多段ビュー
- ビュー: select文を保存してテーブルとして扱う機能。
- 注意点: 過度に複雑なビューはシステムに負担をかける。
データクレンジング
- 目的: データをデータベースに登録できる状態にする。
- 方法: 一意キーの特定、名寄せ、ダブルマスタの防止。
第9章
一歩進んだ論理設計
木構造の特徴
- ノード: 木の結節点
- ルートノード: 木が始まるトップのノード
- リーフノード: 終着点のノード
- 内部ノード: ルートでもリーフでもない中間のノード
- 経路(パス): あるノードから別のノードへの道筋
伝統的な解法
- 隣接リストモデル: ノードのレコードに親ノードの情報を持たせる
新しい解法
- 入れ子集合モデル
- ノード間の階層関係を円の包含関係で表す
- 検索は効率的だが、更新時のパフォーマンスに問題あり
- 入れ子区間モデル
- 実数を扱うモデル
- 経路列挙モデル
- ルートをディレクトリとみなし、各ノードまでの経路を記述
経路列挙モデルの利点と欠点
- メリット: 検索のパフォーマンスが良い
- 更新時は親ノードの追加が大変
各モデルのまとめ
- 隣接リストモデル: 更新や検索が複雑
- 入れ子集合モデル: 検索に効力があるが、更新時に問題あり
- 入れ子区間モデル: 実数を扱うが、更新時のパフォーマンスに問題あり
- 経路列挙モデル: 検索は容易だが、親ノードの追加が大変
難しかったところ
- 初学者が中級者向けにステップアップするためを目的とされているので基本用語の解説はほぼない。
- 後半のバッドノウハウ、グレーノウハウ章に行けば行くほど難しくなっていく。
- 演習問題は前半の章は比較的易しいが、後半の演習問題は調べてください系以外は初学者だとなかなか解けない。
終わりに
前半の章はSQLを先に学んでいたため何とかついていけた印象でした。 バッドノウハウ、グレーノウハウは実際に設計したことがなかったためイメージが湧きづらかったので 設計前や詰まったタイミングでまた読み返したいと思いました。
【初学者向け】『プロを目指す人のためのRuby入門』を読んだ
はじめに
プロを目指す人のためのRuby入門[改訂2版] 言語仕様からテスト駆動開発・デバッグ技法まで Software Design plus Kindle版
こちらを読んだ感想記事です。
著者である伊藤 淳一さんの推奨されている読み方で一通り読みました。
ザーッと読む程度であれば、1日1,2時間で1週間で読めればいいかなって感じらしいです。 自分は10日間ぐらい空いた時間と休日全部を使用して読みました。
目次
1章:ざっと目を通す程度
2章:基礎的な内容
3章:簡単な内容だがやらないと以降の章がわからなくなる可能性がある
1~6章は必ず読む(ここまでで手続き型言語の学習が完了となる)
7章:7.8まで読む(他は読み飛ばす)
8章:8.4まで読む(読み飛ばす。以降サブセクションも読んでいいが、実務的な内容になるので必要になったらでいい)
9章:9.5まで読む(基本ざっと読む)
10章:10.4までざっと読む(railsはprocが出てくる。スコープがrailsでよく使われているということを理解)
11章:ver3.0からの新しい機能。分岐表現の一つ。一応例題まではやる
12章:読むべき
13章:読むべき(でもまぁざーっと読む)
付録:Railsに入るまでの知識
例に挙げられているプログラムを全て写経せずに、例題や気になったところだけでいい。 遅くとも2週間で読み終わるペースで,なるべく早く読む。
良かったところ
1.各章ごとの内容が濃い!
初学者からプロへステップアップするためにという趣旨に沿っているため初学者にも例題を示し分かりやすく記載している。
上級者向けの内容も記載されていたが、正直今の自分のレベルではまだまだ理解に及ばない部分ばかりで課題を進めていく時に必要になったら読むようにする。
2.業務レベルでの内容も組まれている
業務で実際に使われる書き方に加えて、ver〇〇だとエラーにならないがver〇〇だとエラーになるという細かい内容も記載されている。
3.最後まで読み切るコツをオフシャルで推奨してくれている
本書は初学者に向けて「頭の中にインデックスを作る」ことを目的に学習することを薦めています。初学者にとっては内容が複雑で、わからない事がたくさん増えることで学習から遠ざかってしまうことも想定されます。そのため学習のハードルを下げて進めてOKと記載してあるので、9章以降はインデックス方式にチェンジして読み進めました。
学んだこと
Rubyに関する基礎知識
・ 文字列 ・数値 ・真偽値と条件分岐 ・メソッドの定義
この4つ細かく掘り下げて記載されていたので、Progateで習った内容以外の発見もたくさんありました。
Minitestを用いた自動テスト
Minitestは、Rubyで使えるテストライブラリでテストコードを使って自動で確認できる。
require "minitest/autorun"

class SimpleTest < Minitest::Test
  def test_addition
    assert_equal 2 + 2, 4
  end
end
例えば上記であれば2+2が4と等しいかをテストしています。
配列・繰り返し処理
numbers=[1,2,3,4]
sum=0
numbers.each do |n|
    sum += n
end

sum#=>10
最初に配列が定義されている。sum=0で初期化。
.eachメソッドで配列の最初の要素を取り出し sum+= nで取り出した要素をsumに加算していき、
これを最後の要素までループする。
読む前は簡単な繰り返し処理で何も見ずに正確に日本語化するのが出来ていなかったので、4章はとても勉強になりました。
正規表現
著者である伊藤 淳一さんがqiitaに正規表現についての分かりやすい記事を掲載されています。 私は、この記事を読んでからようやく技術書に書いてある内容が少しずつ読めるようになりました!
初心者歓迎!手と目で覚える正規表現入門・その1「さまざまな形式の電話番号を検索しよう」
初心者歓迎!手と目で覚える正規表現入門・その2「微妙な違いを許容しつつ置換しよう」
初心者歓迎!手と目で覚える正規表現入門・その3「空白文字を自由自在に操ろう」
初心者歓迎!手と目で覚える正規表現入門・その4(最終回)「中級者テクニックをマスターしよう」
おわりに
チェリー本の名で称される名著を1から読んでみてとても参考になる部分が多い中、自分の今のレベル不足で理解が及ばないものや、例題に書いてある処理を読み解くのに時間がかかったりしてほぼ10日間ずっと読んでました。まだまだ、自分の及ばない部分がたくさんあるので何回も読み直してアウトプットを積極的に行い自分の知識として定着させれるようにしていきたいです。
【初学者向け】既存プロジェクトをDocker化してみよう!
ゴール
既存のrailsプロジェクトををdocker,docker-composeを使用して 環境構築を行いローカルでwebアプリケーションをブラウザ上で表示する。
※本記事はDockerについての記事のため、LinuxのコマンドとGitコマンドの初歩的なものはご自身で出来るという設定で記載しています。
事前準備
- ローカルの環境
PC: mac M1チップ Sonoma 14.0
エディタ:VScode
- 各種バージョン
ruby 3.2.2
Rails 7.0.6
postgresql 12.0
- docker,docker-composeのインストール
手順
1.対象プロジェクトをGithubからクローン(コピー)してくる
2.Dockerfile、doccker-compose.ymlの作成と記述
3.database.ymlファイルの編集
4.コンテナ生成と実行
5.動作確認
全体像としてはこのような流れです。次は各項目の解説していきます。
1.対象プロジェクトをGithubからクローン(コピー)してくる
Github上から対象プロジェクトをクローンするために下記のコマンドを使用します。
git clone <リポジトリパス>
ここからはクローンしてきたディレクトリで作業をします。
2.Dockerfile、docker-compose.ymlの作成と記述
Dockerfileとは?
Dockerfileは、Dockerコンテナの"設計図"のようなものです。このファイルには、コンテナに何をインストールするか、どのように設定するかなど、コンテナを作成するための手順が書かれています。
なぜDockerfileが必要なのか?
Dockerfileを使用すると、コンテナの作成手順を明確にし、それを再利用や共有が可能になります。これにより、同じ環境を再現するのが簡単になります。
Dockerfileは、Dockerコンテナを作るためのレシピのようなものです。このファイルに従って、Dockerはコンテナを作成します。これにより、必要な環境を正確に再現することができます。
docker-composeとは?
docker-composeを使うと、複数のコンテナを簡単に扱えるようになります。そして、その設定はdocker-compose.ymlファイルに書かれています。
docker-composeは、複数のDockerコンテナを一度に管理・実行するためのツールです。一つのコマンドで複数のコンテナを起動・停止できるので、複雑なアプリケーションを簡単に扱えます。
docker-compose.ymlとは?
docker-compose.ymlは、docker-composeがどのようにコンテナを実行するかの設定を書くファイルです。この中に、使用するイメージやコンテナ間のリンク、ポートの設定などが記述されます。
前置きが長くなりましたが下記からDockerfileとdocker-compose.ymlの実際のコードです。
touch Dockerfile
対象プロジェクト直下で上記のコマンドを実行しファイルを作成する。
FROM ruby:3.2.2
RUN apt-get update && apt-get install -y \
  build-essential \
  libpq-dev \
  nodejs \
  postgresql-client \
  yarn
WORKDIR /rails-docker
COPY Gemfile Gemfile.lock /rails-docker/
RUN bundle install
エディタを使用し、Dockerfileを上記のように記載します。 下記に一行ずつの解説を記載していきます。
FROM ruby:3.2.2- ベースをRubyのバージョン3.2.2を使うように指定しています。
RUN apt-get update && apt-get install -y \- システムを最新の状態に更新してインストールするようにします。インタラクティブ(対話的)な質問に対しては、全てYESで答えるように-yオプションをつけています。
build-essential \- 必要な基本的なツールを取り込んでいます。
libpq-dev \- PostgreSQL(データベース)とやり取りするためのツールをインストールしています。
nodejs \- JavaScriptを使うためのツール、Node.jsをインストールしています。
postgresql-client \- PostgreSQLのクライアントツールをインストールします。これにより、コンテナからPostgreSQLサーバに接続できます。
yarn- JavaScriptのライブラリを管理するツール、yarnをインストールしています。
WORKDIR /rails-dockerCOPY Gemfile Gemfile.lock /rails-docker/Gemfile(Rubyのツールリスト)をコンテナに移しています。
RUN bundle installGemfileに書かれているツールを全てインストールしています。
このDockerfileは、Ruby on Railsアプリケーションを動作させるためのDockerコンテナを作成するための設計図です。必要なツールやライブラリをインストールし、アプリケーションの依存関係をセットアップしています。
docker-compose.ymlの記述
以下のコマンドでdocker-compose.ymlを作成します
touch docker-compose.yml
作成したdocker-compose.ymlをエディタで編集していきます。
version: '3'

volumes:
  db-data:

services:
  web:
    build: .
    command: bash -c "rails db:migrate && rails s -p 3000 -b '0.0.0.0'"
    ports:
      - '3000:3000'
    volumes:
      - '.:/rails-docker'
    environment:
      - 'DATABASE_PASSWORD=postgres'
    tty: true
    stdin_open: true
    depends_on:
      - db
    links:
      - db
  db:
    image: postgres:12.0
    volumes:
      - 'db-data:/var/lib/postgresql/data'
    environment:
      - 'POSTGRES_USER=postgres'
      - 'DATABASE_PASSWORD=postgres'
      - 'POSTGRES_HOST_AUTH_METHOD=trust'
webとdbという2つのコンテナを動かすための設定です。
webはRailsアプリケーション、dbはPostgreSQLデータベースを表しています。
こちらも一行ずつ解説していきます。
version: '3'- Docker Composeのバージョンを3に指定しています。
volumes:- ボリューム(データを保存する場所)の設定。
db-data:db-dataという名前のボリュームを作ります。
services:- サービス(動かすコンテナの設定)を定義します。今回の場合だとwebとdbが該当します。
web:webという名前のサービスを設定します。Railsのwebサービスと、後述のPostgreSQLのdbサービスの2つのコンテナが起動します。
build: .- 現在のディレクトリのDockerfileを使ってイメージをビルドします。
command: bash -c "rails db:migrate && rails s -p 3000 -b '0.0.0.0'"ports: - '3000:3000'- ポートのマッピングを設定し、ホストの3000番ポートをコンテナの3000番ポートに繋げます。
volumes: - '.:/rails-docker'environment:- 環境変数を設定します。
- 'DATABASE_PASSWORD=postgres'- データベースのパスワードを設定します。
tty: true- 出力を見やすくします。
stdin_open: true- 標準入力をオープンします。
depends_on:- コンテナの作成順序の設定です。
depends_on: -dbは、Postgresのコンテナが起動してからRailsのコンテナを起動するという意味です。
- コンテナの作成順序の設定です。
links: - dbwebサービスはdbサービスとリンクされます。
db:dbという名前のサービスを設定します。
image: postgres:12.0- 使うイメージを
postgresのバージョン12.0に指定します。
- 使うイメージを
volumes:- ボリュームのマッピングを設定します。
- 'db-data:/var/lib/postgresql/data'db-dataボリュームをコンテナの指定の場所にマッピングします。
environment:- 環境変数を設定します。
- 'POSTGRES_USER=postgres'- PostgreSQLのユーザー名を設定します。
- 'DATABASE_PASSWORD=postgres'- データベースのパスワードを設定します。
- 'POSTGRES_HOST_AUTH_METHOD=trust'- 認証方法を
trustに設定します。
- 認証方法を
2.database.ymlファイルの編集
default: &default
  adapter: postgresql
  encoding: unicode
  pool: <%= ENV.fetch("RAILS_MAX_THREADS") { 5 } %>
  host: db
  user: postgres
  password: <%= ENV.fetch("DATABASE_PASSWORD") %>

development:
  <<: *default
  database: rails-docker_development

test:
  <<: *default
  database: rails-docker_test

production:
  <<: *default
  database: rails-docker_prod
今回はdocker-composer.ymlで設定した内容をもとに、database.ymlのデフォルトでは記述されていないhost username passwordを追記しています。
  host: db
  user: postgres
  password: <%= ENV.fetch("DATABASE_PASSWORD") %>
3.コンテナの生成と実行
下ごしらえが完了したので、dockerのコマンドを使ってrailsの環境を構築していきます。
- イメージの作成
docker-compose build
- DB作成
docker-compose run web rails db:create
※docker-compose run の後はサービス名を指定しないとNo such servicesのエラーが出るので、サービス名の指定は忘れずに...。
- コンテナの作成と起動
docker-compose up
これでrailsアプリをDocker化する手順は以上です。
※今回はdocker-compose.ymlのcommandにrails db:migrate && rails s -p 3000 -b '0.0.0.0'を記述しているので,db:createのみrunしています。
4.動作確認
docker compose psでrails serverが動いてるのを確認し
ローカルに接続し、ブラウザにて画面が正しく表示されれば無事終了です。
おわりに
今回dockerを学んでみて最初はやること書くこと多すぎ!とかなり混乱していたのですが、少しづづ慣れていって無事既存のrailsプロジェクトをdocker化することができました。 教材を見返しながら一つずつやっていたのでかなり時間はかかりましたが、docker化の便利さがとともよく分かるいい機会でした。 まだまだdockerについては初学者程度の知識しかないので、使いこなせるようにたくさんハンズオンをしていきたいと思います。
【初学者向け】GitHub Pagesを使ってみよう!
はじめに
GitHub Pagesを使って簡単なホームページを作成してwebに公開しました。 備忘録も兼ねてやり方をまとめてみたいと思います。
resumeはこちら
https://rocky-engineer7.github.io/resume.io/startbootstrap-resume-gh-pages/index.html
GitHubアカウントは既に登録済みであるということを前提にして説明をしていきます。
またGitのコマンドの中でadd, commit, pull, push程度のコマンドは学習済みということを想定しています。
GitHub Pagesとは
GitHub Pagesは、GitHubの無料ホスティングサービスで、静的なウェブサイト(ユーザー操作で内容が変わらないサイトやJavaScriptを含むサイト)を公開することができます。動的サイトの公開は不可です。GitHubアカウントがあれば、レンタルサーバーなしで簡単にサイトを公開できます。
GitHub Pagesの公開までの流れ
2.リモートリポジトリ内に公開したいファイルを追加(アップロード)
3.GitHub Pagesでサイトの公開
上記の手順を行うことでGitHub Pagesで自身が作成したサイトを公開することができます。
公開までの手順
1. リモートリポジトリを作成
GitHubのアカウント作成,もしくはログインをしてサイト上部の➕ボタン押下して
New repositoryを押下。
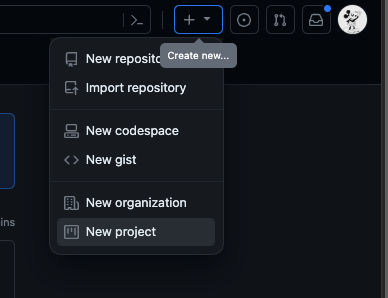
画面が遷移してリポジトリ作成画面が表示される。赤枠で囲った部分にリポジトリ名を入力する。
入力完了後、下にあるCreate repositoryを押下する。
Publicで作成しないとGitHub Pagesを使えません。
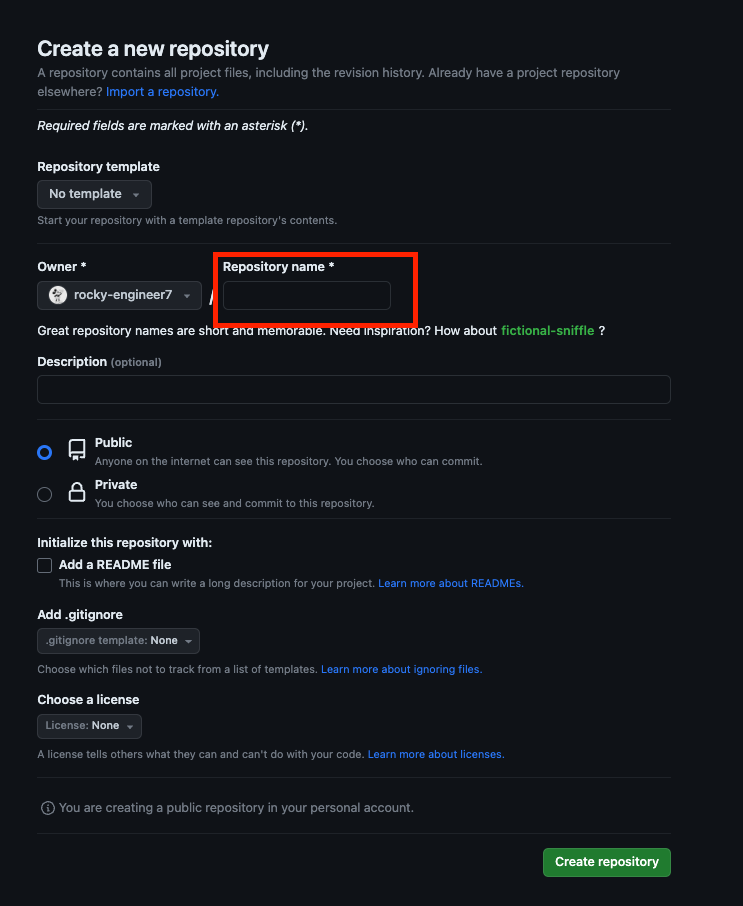
今回はtest1とリポジトリ名をつけて作成しました。
リポジトリを作成したら一番最初にこの画面が表示されます。
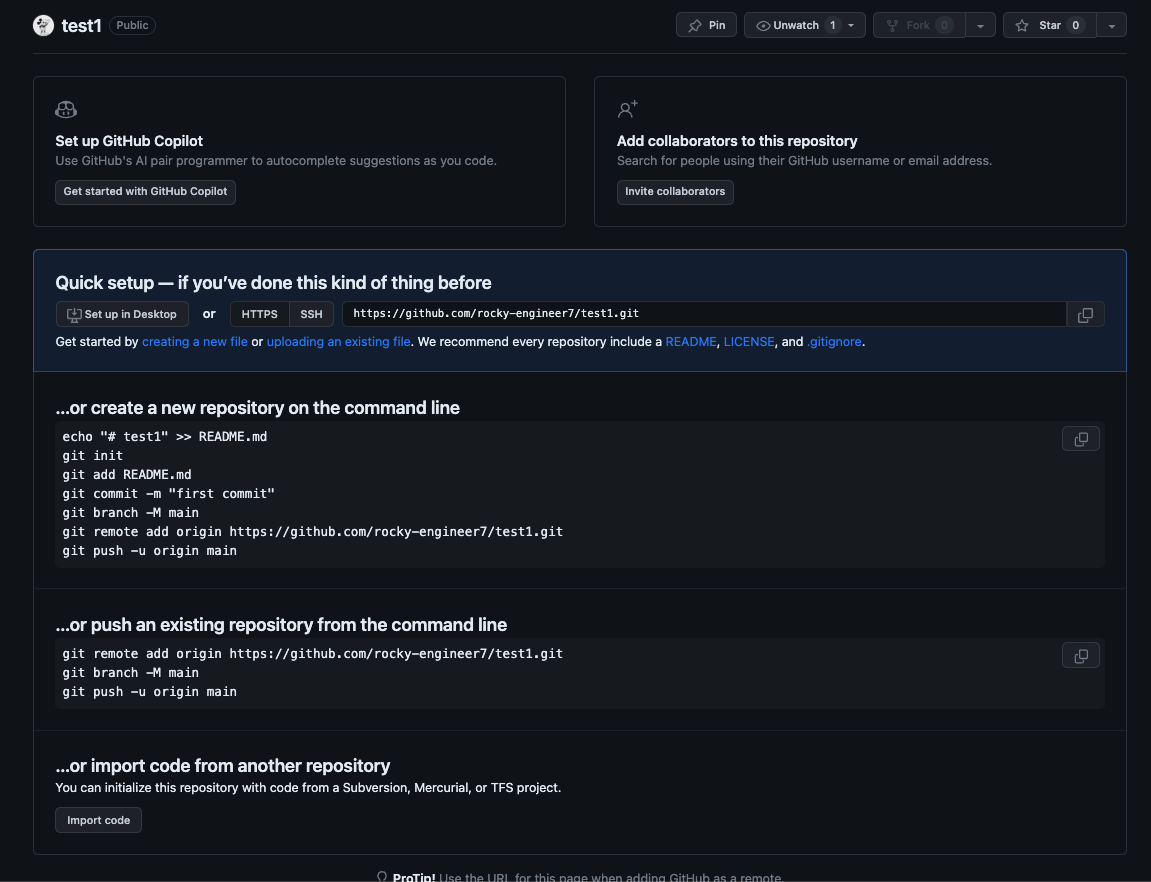
2.リモートリポジトリ内に公開したいファイルを追加(アップロード)する
今回は以下のようにVSCodeで作成したファイルを使用します。
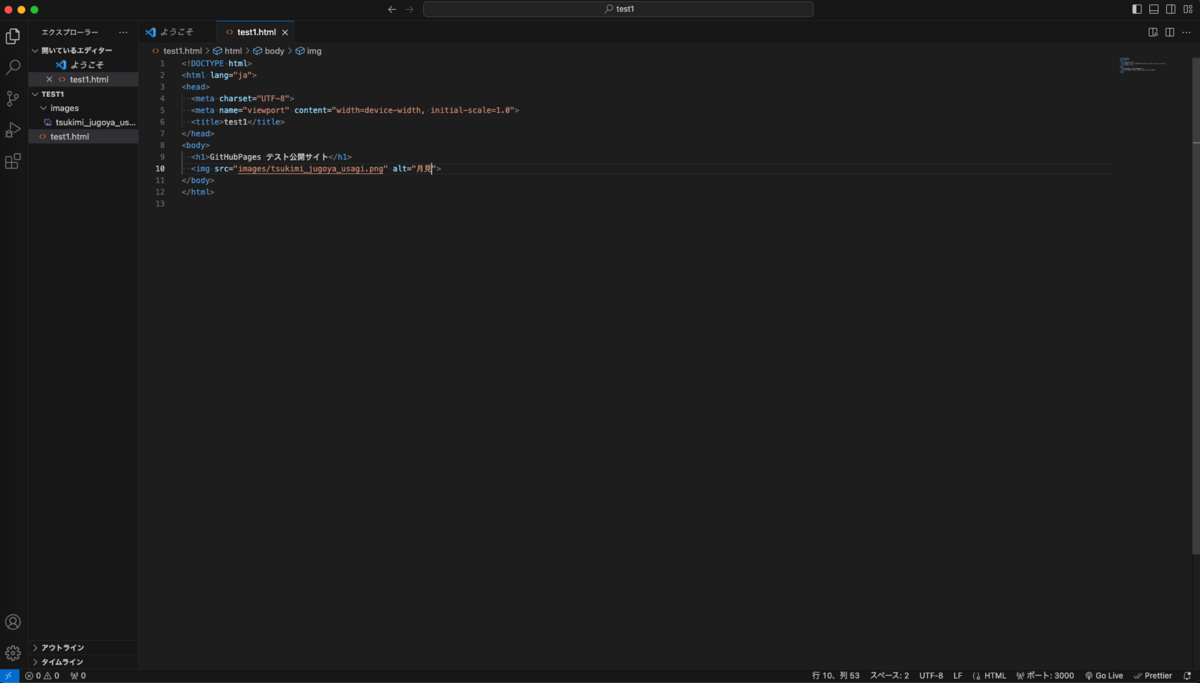
ターミナルで下記のようにコマンド入力をしてリモートリポジトリにローカルリポジトリの内容をプッシュします。
$ git init

$ git add .

$ git commit -m "first commit"

$ git remote add origin git@github.com:rocky-engineer7/test1.git

$ git branch -M main

$ git push -u origin main
リモートリポジトリで内容が反映されているかを確認。
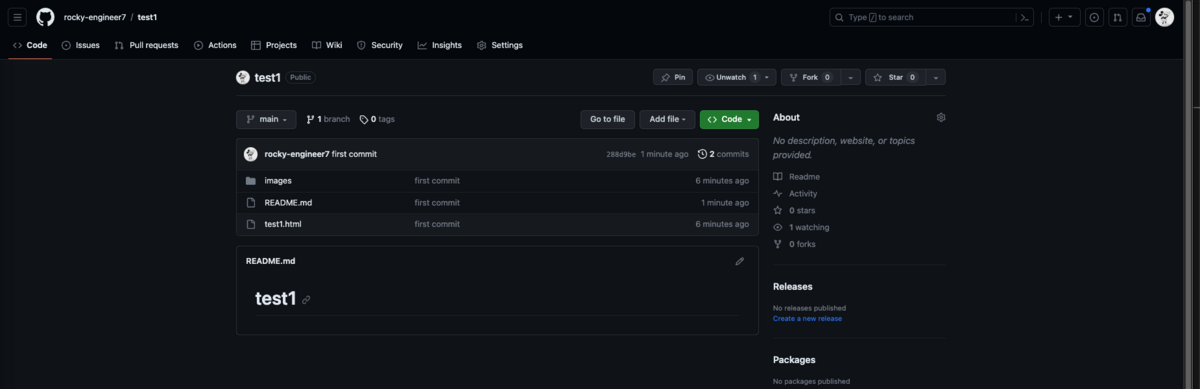
3.GitHub Pagesでサイトを公開する
1.リモートリポジトリで右上にある「Settings」をクリックします。
2.左側のメニューの「Pages」をクリックします。
3.Branchの部分が「None」になっているため「main」に変更します。
4.「Save」をクリックします。
5.しばらくすると以下のようにGitHub Pagesの部分にURLが発行されます。
6.「visit site」をクリックします。
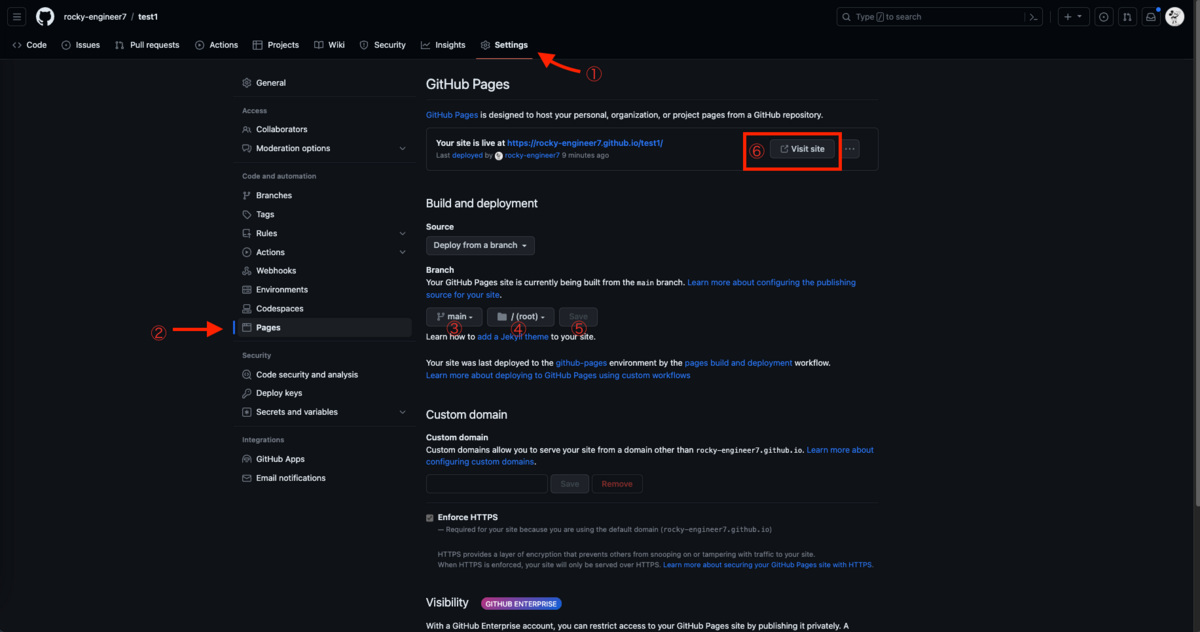
GitHub Pagesで公開する際に躓いた部分について
README.mdが表示されてしまう
Github Pagesで公開でき「https://(アカウント名).github.io/(リポジトリ名)」にアクセスすると、README.mdの内容が表示されてしまいました。 調べたところGithub Pagesで公開する際に指定したリポジトリの直下にREADME.mdがある場合はそちらが優先的に公開されてしまうとのことでした。 こちらでも簡単に手順を記載いたします。
「.githubフォルダ(注:フォルダ名のドットを忘れずに)」を作成します。
mvコマンドを使用して、README.mdを「.githubフォルダ」を移動させます。($ git mv README.md .github)
変更した内容をローカル→リモートへプッシュ
無事にWebページでindex.htmlが表示されるようになります。
404NotFoundが表示されたら
結論から言うと、URLのパスが抜けているからです。 GitHub Pagesで表示されているURLはrootの直下にあるindex.htmlはそのままでも表示できるみたいですが、今回はtest1のフォルダを作成しその中にindex.htmlのファイルを作成したのでパスを指定しないと表示できない!と言うのが答えです。
こちらが最初に作成されたURL
https://rocky-engineer7.github.io/test1
htmlのパスを指定(test1.html)したら表示される
https://rocky-engineer7.github.io/test1/test1.html
おわりに
学習の一環で「GitHub Pages」で簡単なサイトを公開するにあたり、HTMLの知識、GitとGithubの知識をインプットしてからアウトプットを行ったので、苦手意識が少し改善されました。
これからも、まだまだ色々な勉強や課題に取り組んでいくと思いますが、インプット→アウトプットの流れでガンガン出来るようになりたいです。
